強化学習とは何か - あの「超次元格闘」の裏で何が起きていたのか?
強化学習は、正解データを真似するのではなく、試行錯誤を通じて報酬を最大化する行動を学ぶ機械学習手法です。本記事では、NVIDIA Isaac Simのロボット相撲実験を例に、State・Action・Environment・Rewardの基本構造、教師あり学習との違い、AIがラリアットや空中戦といった予想外の戦略を獲得した理由を解説します。
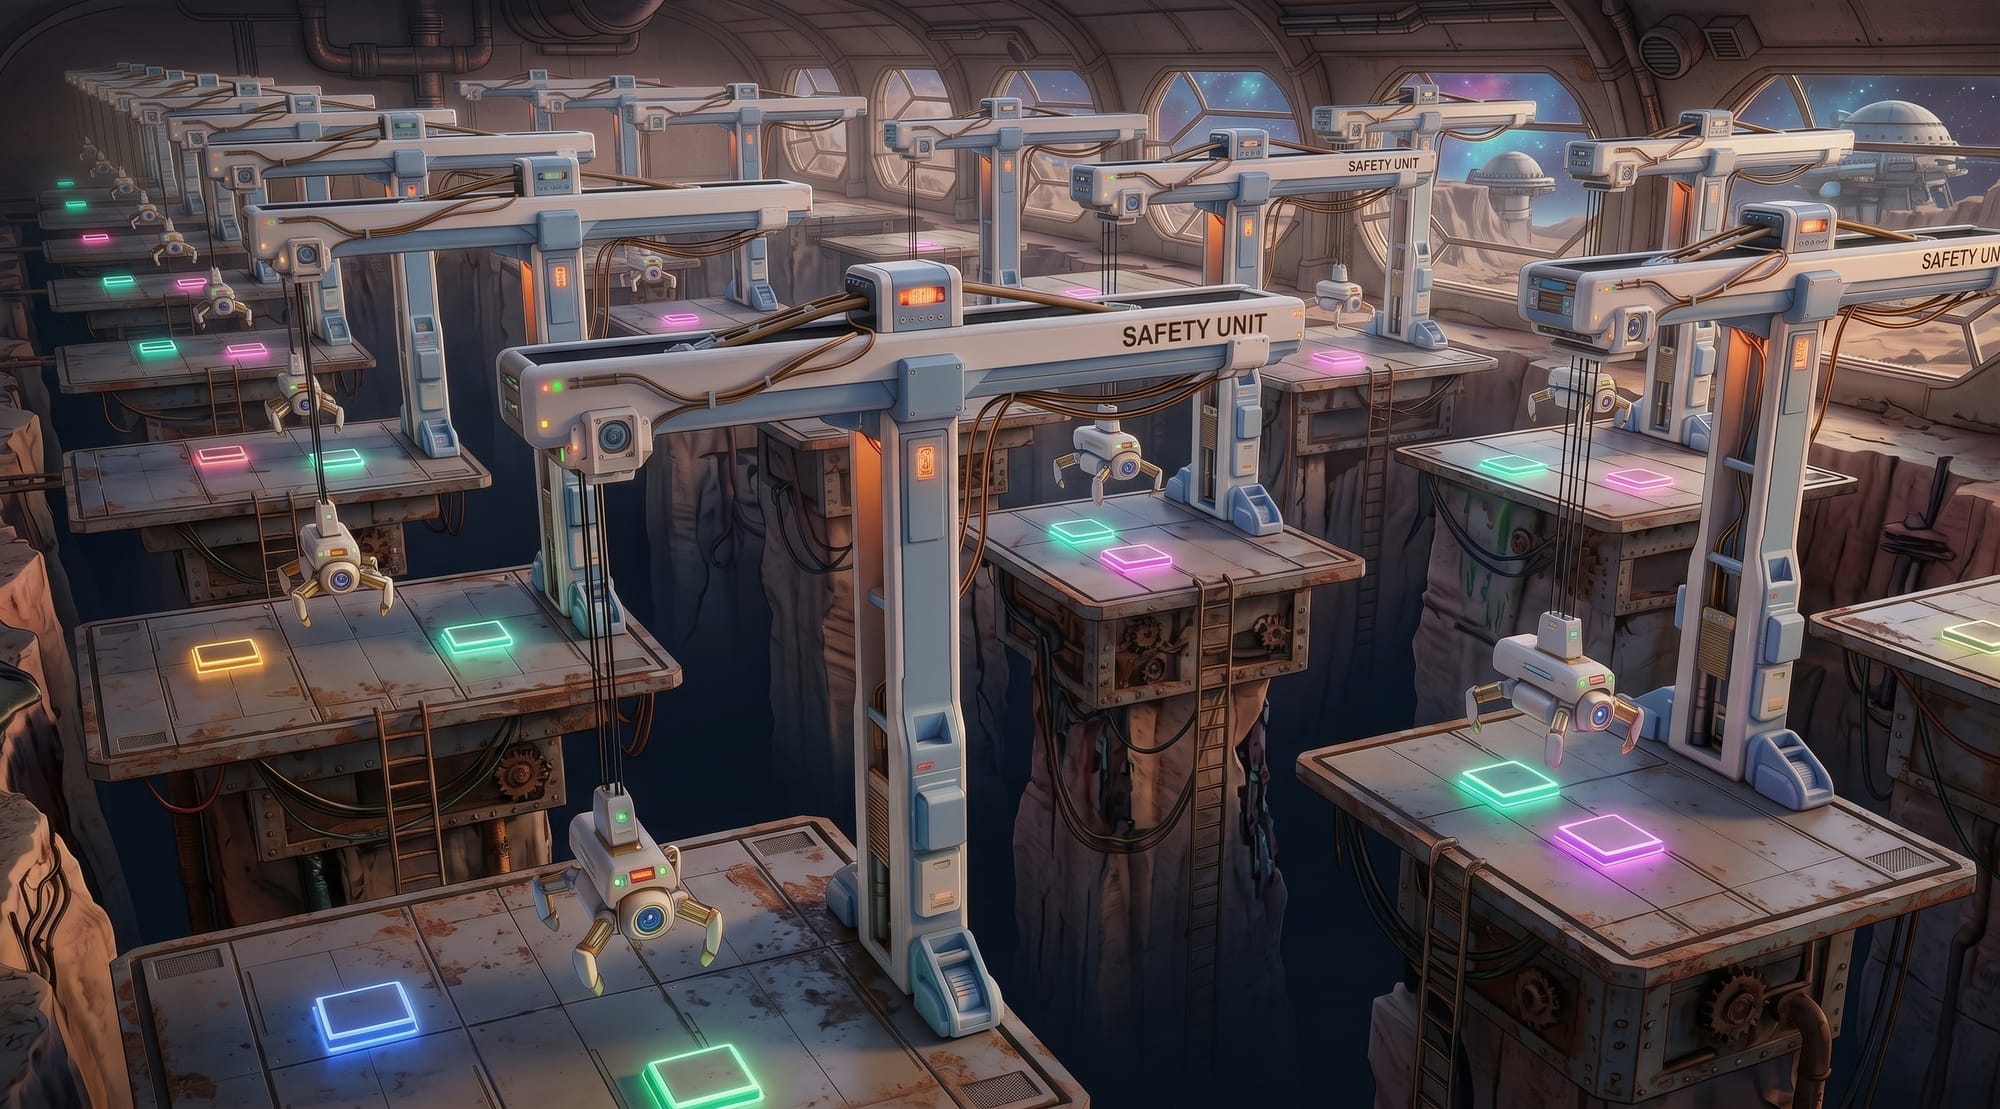
前回の記事では、NVIDIA Isaac Simを使って2台のロボットに相撲を学ばせたところ、エポックが進むにつれて「お見合い」から始まり、最終的には「空中浮遊攻撃」へとカオスな進化を遂げた様子をお届けしました。
あの実験でロボットたちの動きを観察する中で、Isaac Simとは一体どういう製品なのかについて、大きな気づきと学びがありました。
率直な感想として、約6年ほど前に弊社が手掛けていたUnityのML-Agentsと、Issac Simは驚くほどそっくりだという印象を持ちました。
環境(環境+エージェント+報酬+ポリシー)」という概念やパイプライン自体は本質的に全く同じです。
Issac Simは、そのループを回す規模と並列性がUnity ML-Agentsと比較して桁違いですが、どちらも強化学習(RL)のループを回すための環境という意味では完全に共通です。
今回は、自分の理解を整理するためにも、この強化学習という手法の本質についてまとめてみたいと思います。
真似すべき正解(お手本)」が存在しない
強化学習は機械学習の手法の一つですが、他の手法と大きく異なるのでは「真似すべきお手本データが存在しない」という点です。
例えば、文章生成AI(LLMなど)のような学習では、「この文脈の次に来るべき理想的な文字列(正解)」が存在し、AIはその正解にどれだけ近づけるかを目指します。
しかし、相撲ロボットには「これが美しい相撲の動きだ」という関節の動きや手本のデータは一切与えられていません。
注:(逆に言えば、相撲ロボットにLLMのように正解を見せて「次に取るべき行動」を手取り足取り教えれば、理論上はLLMのようなお行儀の良い相撲ロボットが生まれます。この話はまたいつかの機会に)
強化学習にあるのは、お手本ではなく「評価のルール(得点表)」だけです。
ゴールはあるが、そこに至る「手段は問われない」
お手本がないAIはどうやって動くのかというと、「試行錯誤」です。
根も歯もない言い方をすれば「死にゲー」です。
普段ゲームをあまりされない方には余計にややこしくなってしまいますので、「死にゲー」とは何かを先にご説明しておきますと、「何度も死んで覚え、身体に攻略法を叩き込むゲーム」です。
一方、教師あり学習(SL)は「死にゲー」というよりは「試験の過去問の丸暗記」に近く、これは両者の根本的な違いを示す決定的な特徴だと言えます。
強化学習=「ノーヒントの超高難易度死にゲー」
強化学習のプロセスは、フロム・ソフトウェアの「エルデンリング」や「ダクソ」を目隠し&攻略本なしでプレイさせられる状態にそっくりです。
手本(攻略本)がない
どう動けばいいか、の正解は誰も教えてくれません。
死んで覚える(試行錯誤)
プレイヤー(AI)は、自ら罠に飛び込み、崖から落ち、ボスに一撃で殺されながら(=ペナルティを受けながら)、「あ、ここは踏み込んじゃダメだ」「このタイミングで回避だ」と自分の失敗データ(死に様)を積み重ねて攻略パターンを自力で構築します。
相撲ロボットが「お見合い」から「空中戦」に進化していったのも、何万回と土俵から落ちて「死ぬ」ことでしか勝ち筋を見つけられなかったからです。
まさに「死にゲーの極致」と言えます。
強化学習は、常に以下のループで動いています。
- 状態(State): 今の自分の体勢や相手との距離
- 行動(Action): 関節をどう動かすか
- 環境(Environment): Isaac Sim上の物理空間
- 報酬(Reward): その結果もらえる「得点」または「ペナルティ」
AIに与えられた命令は「とにかくトータルで一番高い得点(報酬)を獲得しろ」ということだけです。
「ゴール(高得点)は指定するけれど、そこに至る道筋や手段は一切問わない。自分で試行錯誤して見つけ出しなさい」というスタンスなのです。
なぜ「空中戦」にたどり着いたのか?
この「手段は問わない」という特徴こそが、あのカオスな進化の理由でした。
人間であれば「相撲なのだから、相手を押して土俵の外に出そう」と考えます。しかし、手本を持たないAIには「相撲の美徳」や「人間の常識」はありません。
AIにとっての正解は、あくまで「ルールの範囲内で、最も手っ取り早く得点を稼ぐこと」だけです。
その結果、AIが試行錯誤の果てに見つけ出した攻略法が、
- 接触してバランスを崩す原因になる「腕」を背中にたたむ
- 手っ取り早く倒せる「ラリアット」を叩き込む
- 相手を空中高く蹴り上げ、摩擦をゼロにして完全にコントロールを奪う
という、人間には思いつかないような究極の物理ハックでした。
「相撲を教えているつもりだったけれど、AIは『物理法則を使ったハイスコア獲得ゲーム』として攻略していたんだ」と気づいた瞬間、ロボットたちの奇妙な動きの理由がすべて繋がりました。
おわりに:AIに意図を伝える難しさと面白さ
今回の実験を通して、「正解を与えずにルールだけで試行錯誤させる」という強化学習の面白さと、同時にその難しさを深く実感しました。
AIは失敗しているのではなく、私たちが与えたルールの隙間を突き、愚直に勝ち筋を探索してくれていたわけです。
人間の想像を超える動きを見せてくれる強化学習の奥深さと破茶滅茶さが、Isaac Simにおいてすら健在であったと知ることができたのは、私たちにとって大きな収穫であるとともに、懐かしさも覚えました。
次回は、このロボットたちに「どういうルール(報酬)を与えれば、人間の意図通りの綺麗な相撲を取ってくれるのか?」という、報酬設計(リワードエンジニアリング)の試行錯誤について挑戦してみたいと思います。
1,000社以上の事業成長を支えた圧倒的な『スピードと柔軟性』で、御社のアイデアを最短で形にします。まずは無料で壁打ちしませんか?